4. LLM Architecture (Part 01)
GPT Backbone
-
Các mô hình Ngôn ngữ lớn (LLM) như GPT (Generative Pretrained Transformer) là những kiến trúc mạng nơ-ron có kích thước khổng lồ.
-
Tuy nhiên, kiến trúc của mô hình này thực chất lại ít phức tạp hơn bạn tưởng, bởi nhiều thành phần bên trong được lặp đi lặp lại (chúng ta sẽ tìm hiểu sau).
-
-
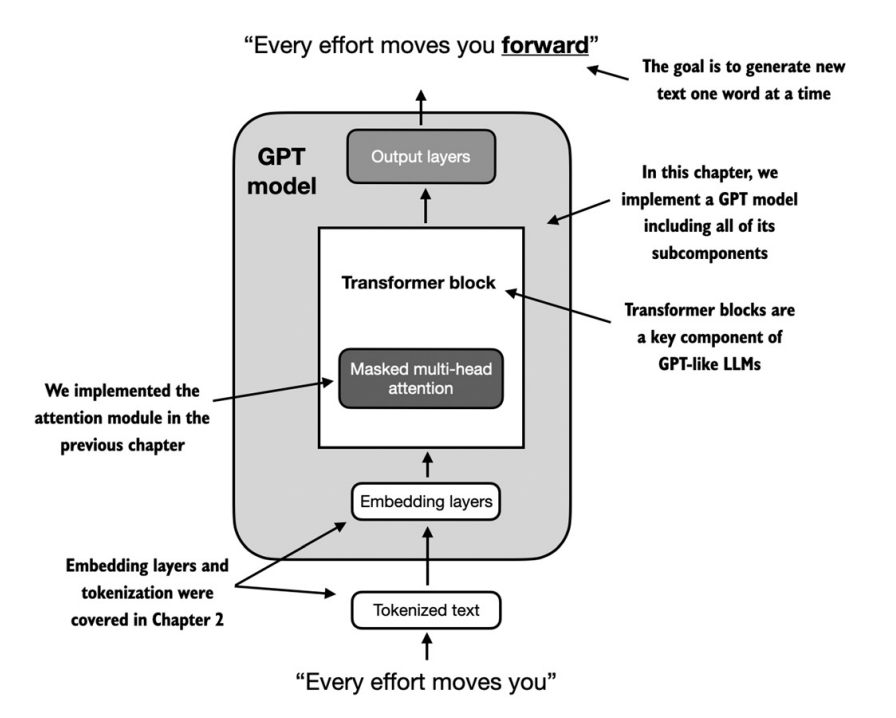
Phía trên là hình mô tả tổng quát về 1 mô hình GPT. Bên cạnh các
embedding layers&inputs tokenization, nó bao gồm 1 hoặc nhiều khốiTransformerchứa modulemasked multi-head attention(đã triển khai ở chương trước). -
Trọng tâm ở chương này sẽ triển khai core của LLM, bao gồm các khối transformer, sau đó chúng ta sẽ huấn luyện ở chương tiếp theo để tạo ra văn bản giống con người.
-
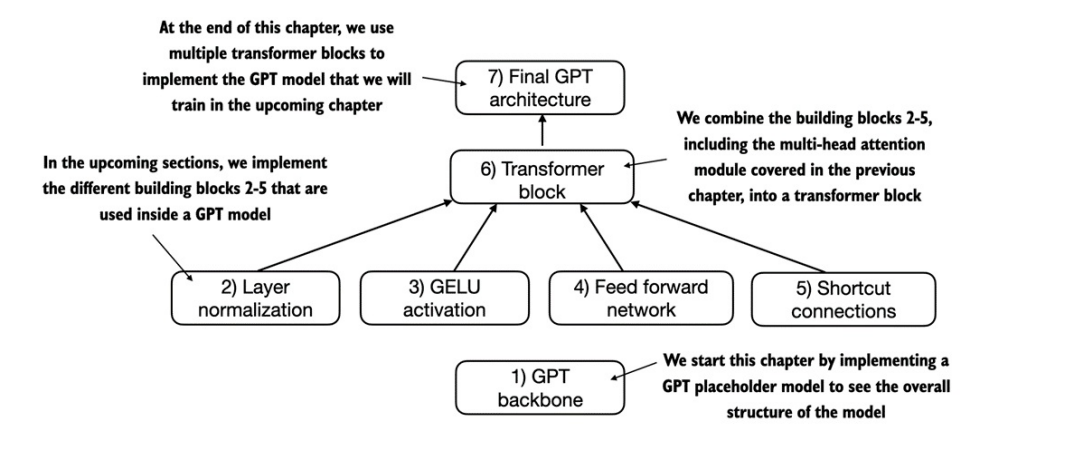
Dưới đây là mô tả các bước để build 1 mô hình GPT hoàn chỉnh.
-
-
Bắt đầu với bước đầu tiên là xây dựng
GPT Backbone, ta sẽ triển khai 1 class làDummyGPTModel- phiên bản đơn giản hóa của mô hình GPT, sử dụng module neural network của Pytorch nn.Module. Kiến trúc của mô hình được triển khai tại phần1. GPT Backbonetrong11. Placeholder-GPT.ipynb.
Layer Normalization
-
Việc huấn luyện
deep neural network(mạng nơ-ron sâu) với nhiều tầnghidden layerdễ gặp vấn đề như vanishing gradient (triệt tiêu đạo hàm) hay exploding gradient (bùng nổ đạo hàm). Điều này có nghĩa mô hình sẽ gặp khó khăn trong việc tìm ra bộ tham số tối ưu để giảm loss. -
Phần này chúng ta sẽ triển khai
layer normalization. Ý tưởng chính là điều chỉnh các giá trị kích hoạt (activations) đầu ra của 1 hidden layer sao cho chúng có giá trị trung bình (mean) bằng 0 và phương sai (variance) bằng 1 - việc điều chỉnh mean & variance này là của Standardization. Để ý thêm 1 điều là tại sao lại chuẩn hóa theo 2 giá trị này, thì bởi vì Phân phối chuẩn dựa trên 2 tham số này.Tại sao lại cần Standardization Z-score?
- Khi dữ liệu truyền qua từng lớp, nếu giá trị kích hoạt thay đổi quá lớn hoặc quá nhỏ, thì khi backpropagation sẽ bị bùng nổ hoặc triệt tiêu đạo hàm. Do đó,
LayerNormsử dụng z-score để chuẩn hóa dữ liệu đưa về thang đo chung ở mỗi bước.
- Khi dữ liệu truyền qua từng lớp, nếu giá trị kích hoạt thay đổi quá lớn hoặc quá nhỏ, thì khi backpropagation sẽ bị bùng nổ hoặc triệt tiêu đạo hàm. Do đó,
-
Trong GPT-2 và các kiến trúc Transformer hiện đại, Layer Normalization thường được áp dụng trước và sau khối multi-head attention và trước output layer.
Hàm kích hoạt (Activations)
- Khi đi qua các tầng Linear thì mô hình chỉ học được các mối quan hệ tuyến tính.
- Hàm kích hoạt lúc này giúp mô hình học thêm các mối quan hệ phi tuyến tính. Ví dụ hàm ReLU chuyển các giá trị âm về 0.
-
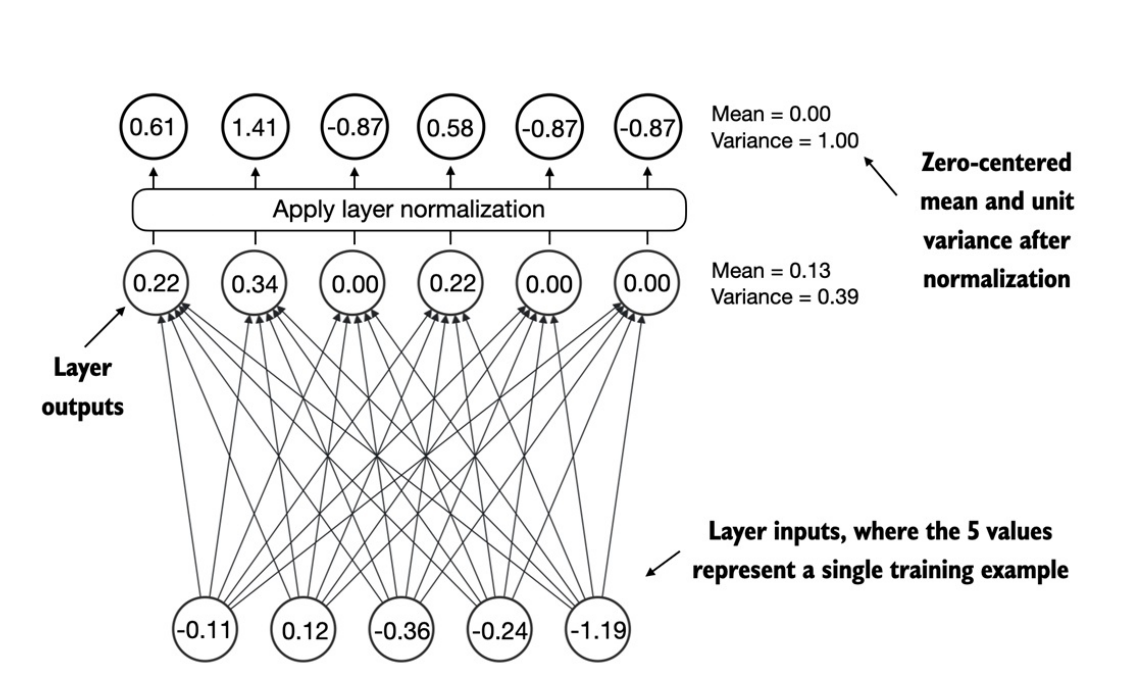
Trước khi đi vào phần triển khai code ta hãy xem qua sơ đồ tổng quan của layer normalization:
-
-
Ở hình trên, khi đi qua tầng hidden layer thì các giá trị đầu ra sẽ được tính toán để đưa về trạng thái có mean bằng 0 & variance bằng 1. Quá trình này giúp ổn định dòng dữ liệu và tăng tốc độ hội tụ mô hình.
-
Code được triển khai tại phần
2. Layer Normalizationtrong11. Placeholder-GPT.ipynb.Chiều (dimension) khi tính mean
-
-
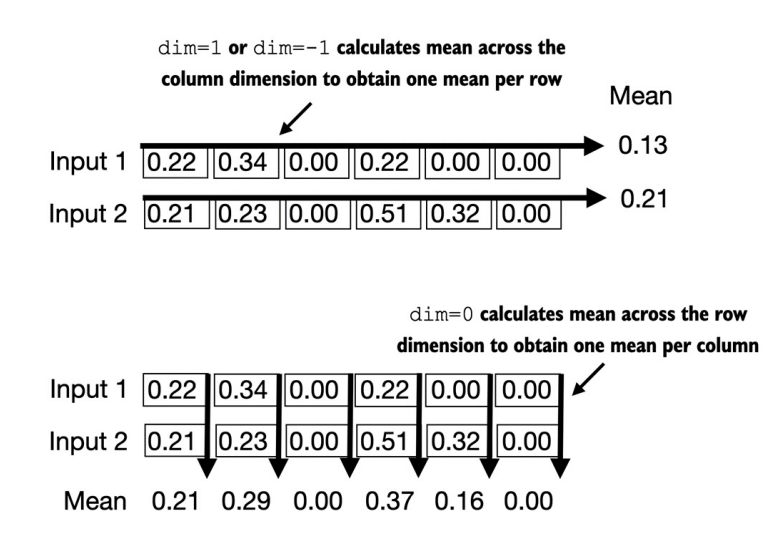
Trên đây là mô tả về chiều tính toán mean trên 1 tensor 2D [rows, columns].
-
Việc sử dụng
dim=-1giúp tính mean trên chiều cuối cùng của tensor. Sau này, khi thêm chuẩn hóa lớp (layer normalization) - nơi tạo ra tensor 3D [batch_size, num_tokens, embedding_dim] thì việc giữ nguyên dim=-1 linh hoạt hơn nhiều so với phải thay đổi thủ công từ dim=1 sang dim=2.
-
-
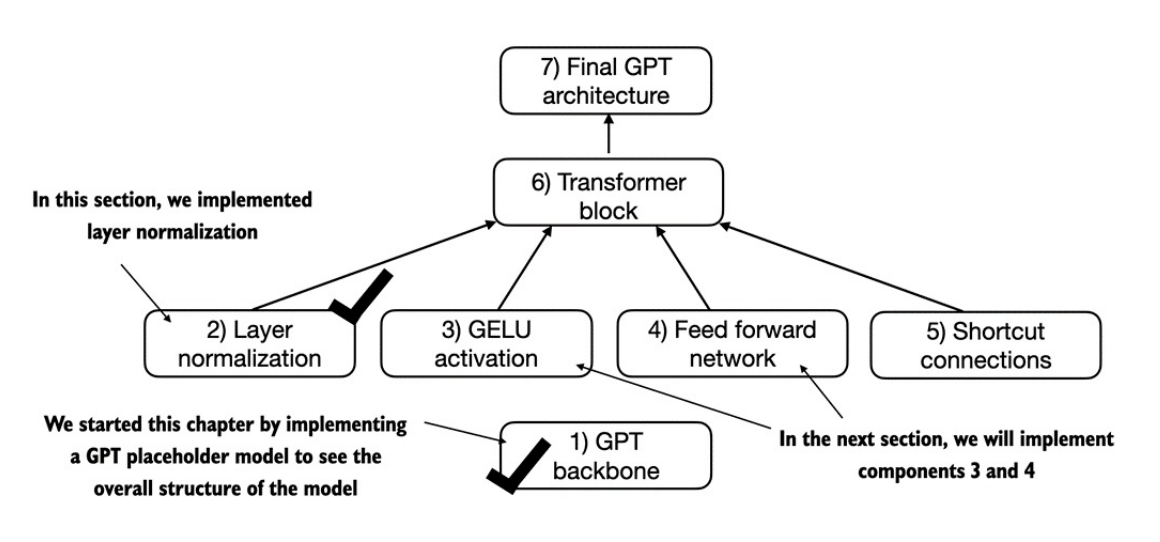
-
Phần sau ta sẽ tìm hiểu về hàm kích hoạt
GeLU- một trong các hàm kích hoạt dùng trong LLMs, thay cho hàm truyền thống ReLU.
GeLU Activations
-
Trước đây, hàm kích hoạt
ReLUđã được sử dụng phổ biến trong học sâu nhờ tính đơn giản và hiệu quả trên nhiều kiến trúc mạng nơ-ron khác nhau. Tuy nhiên, trong các mô hình ngôn ngữ lớn (LLM), người ta thường sử dụng các hàm kích hoạt khác thay thế cho ReLU truyền thống. Hai ví dụ tiêu biểu làGeLU(Gaussian Error Linear Unit) vàSwiGLU(Sigmoid-Weighted Linear Unit), lần lượt tích hợp các đơn vị tuyến tính kiểm soát bởi phân phốiGaussian&Sigmoid. -
Hàm kích hoạt GeLU có thể được triển khai theo nhiều cách khác nhau. Phiên bản chính xác được xác định là , với là
hàm phân phối tích lũycủa Phân phối Gaussian chuẩn. -
Tuy nhiên trong thực tế người ta thường triển khai 1 bản xấp xỉ có chi phí tính toán thấp hơn (GPT-2 gốc cũng sử dụng):
- Code được triển khai tại phần
3. GeLU Activationstrong11. Placeholder-GPT.ipynb.
Feed Forward Network
-
Lớp
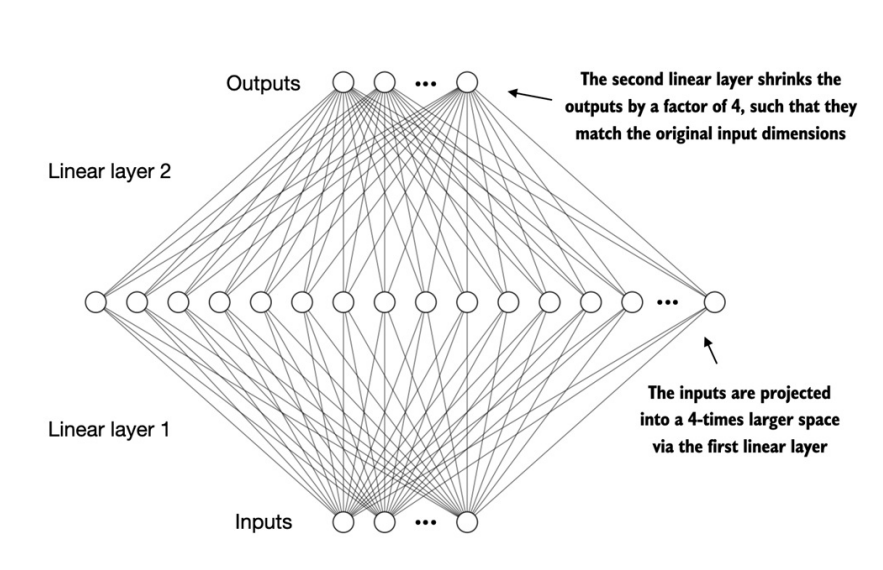
FeedForward (FNN)là 1 mạng nơ-ron nhỏ gồm 2 phép biến đổi tuyến tính và 1 hàm kích hoạt phi tuyến (ở phần này ta sẽ dùng GeLU):-
Mở rộng không gian: FNN đưa các vector đầu vào từ không gian embedding-dim lên không gian có số chiều lớn hơn (ở phần này là gấp 4 lần).
-
Sau đó các vector sẽ được đưa qua 1 hàm kích hoạt để học được các đặc trưng phi tuyến và loại bỏ các đặc trưng nhiễu.
-
Cuối cùng, các vector được chiếu ngược lại về không gian ban đầu để đi tiếp vào các layers sau.
-
-
-
Code được triển khai tại phần
4. Feed Forward Networktrong11. Placeholder-GPT.ipynb.
Shortcut Connections
-
Shortcut Connections, hay còn gọi là skip hoặc residual connections ban đầu được đề xuất trong các mạng nơ-ron sâu trong lĩnh vực CV (Computer Vision) cụ thể là các mạng Residual - ResNet nhằm giảm thiểu thách thức về
Vanishing Gradient(triệt tiêu đạo hàm).-
-
Vanishing Gradient là hiện tượng khi mạng quá sâu, các đạo hàm (gradient) phải nhân với nhau nhiều lần khi truyền ngược từ cuối về đầu (Backpropagation). Nếu các giá trị này nhỏ hơn 1 chúng sẽ càng nhân càng nhỏ.
-
-
-
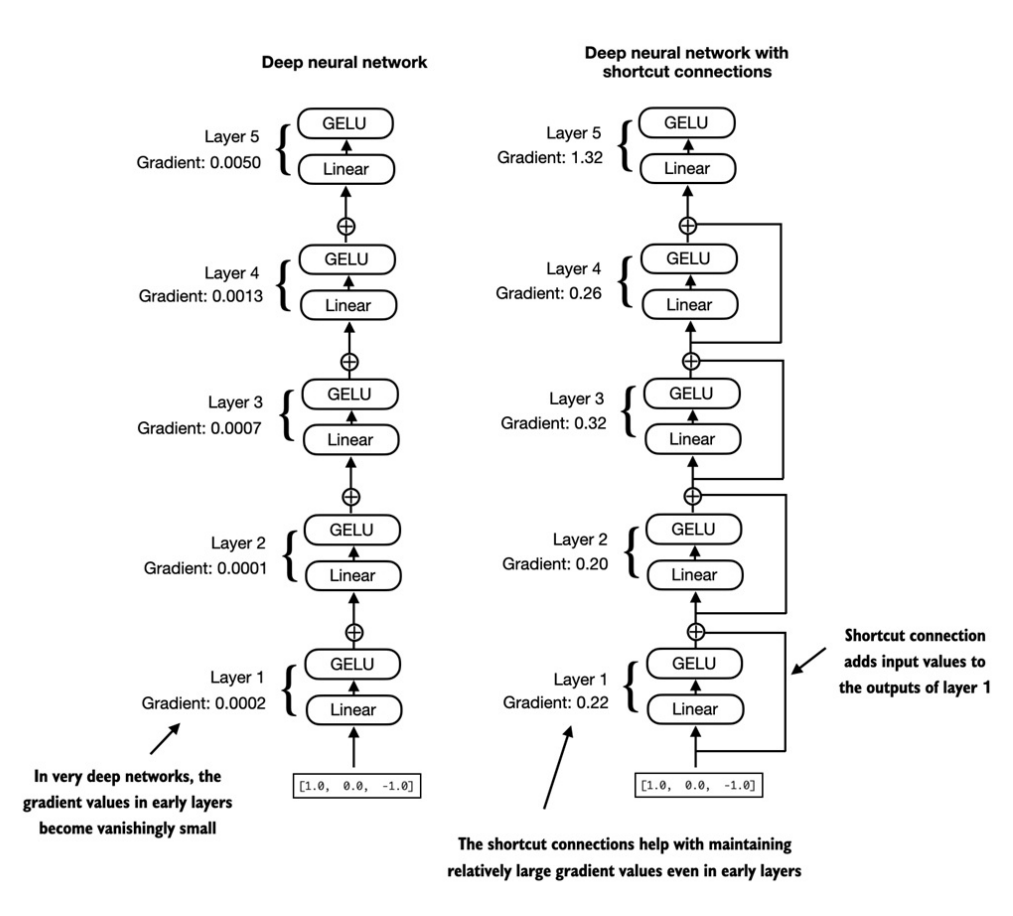
Ở hình trên là 2 mạng nơ-ron sâu gồm 5 lớp có shortcut connections (bên phải) & không có shortcut connections (bên trái). Có thể thấy ở bên trái khi về Layer 1 thì gradient nó đã về rất bé.
-
Để dễ hiểu thì
shortcut connectionslà cộng đầu ra của 1 lớp với giá trị đầu vào trước khi qua lớp đó, triển khai qua công thức sau đây:-
: là dữ liệu đầu vào trước khi đi qua lớp nơ-ron.
-
: đầu ra của 1 lớp Linear.
-
-
Tại sao lại là công thức này?
-
Vì khi đi qua đạo hàm thì công thức này sẽ thành:
-
Khi áp dụng vào backpropagation để tính Gradient truyền về:
-
Nếu có giảm nhỏ bao nhiêu thì vẫn giúp gradient được truyền ngược về đầu mà không bị triệt tiêu.
-
-
Code được triển khai tại phần
5. Shortcut Connectiontrong11. Placeholder-GPT.ipynb.
Transformer Block
-
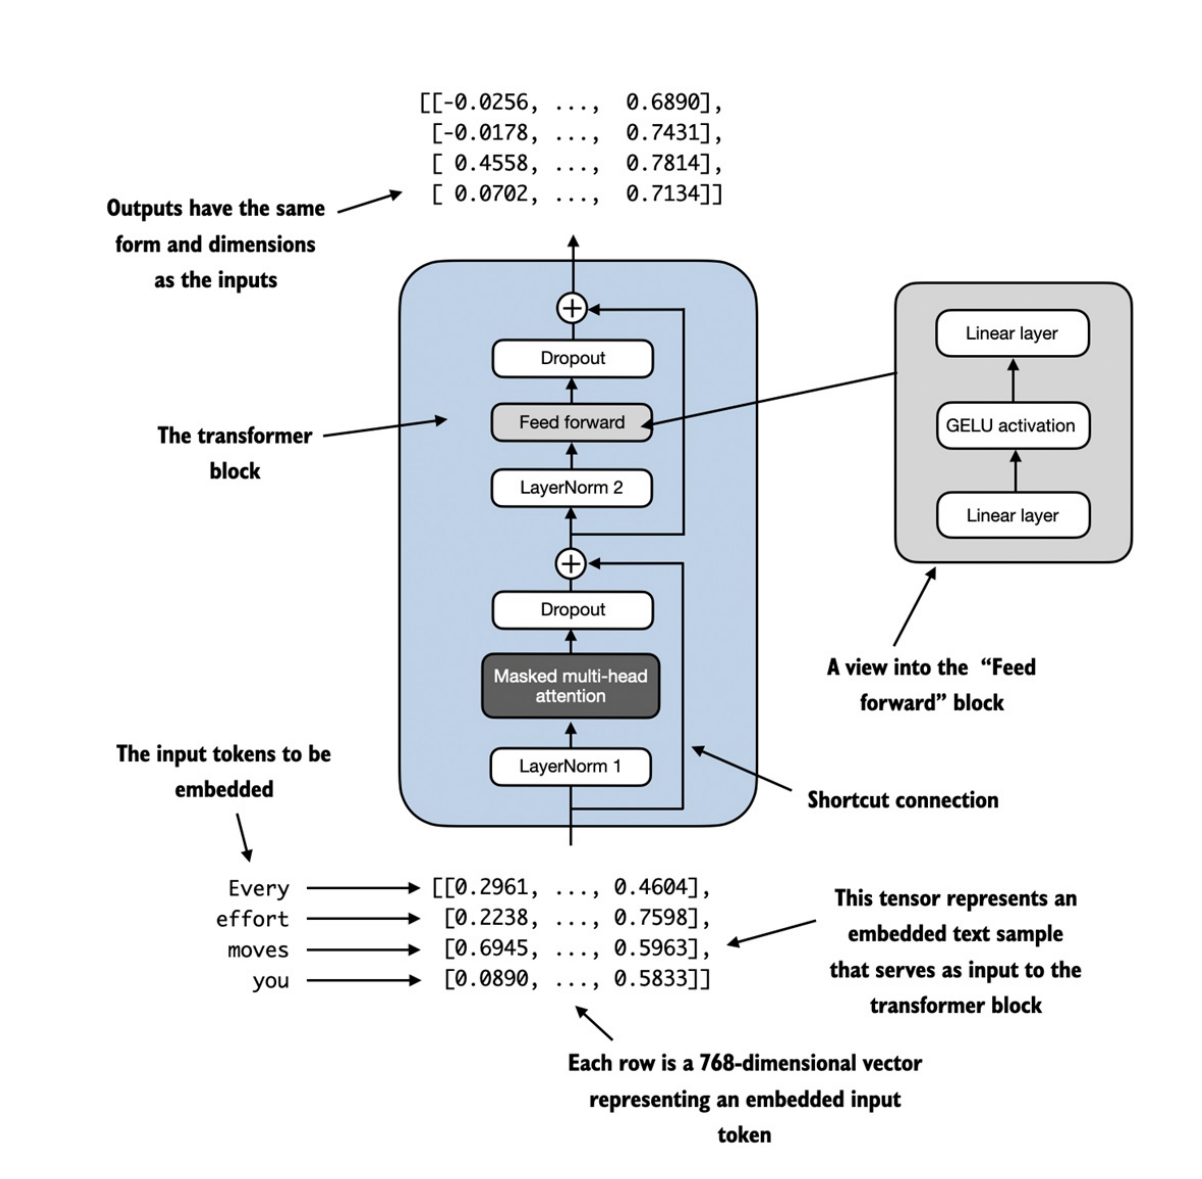
Phần này chúng ta sẽ triển khai đầy đủ các thành phần của 1 khối Transformer hoàn chỉnh. Khối này được lặp lại hàng chục lần trong kiến trúc GPT-2 124M tham số, kết hợp với nhiều khái niệm chúng ta đã tìm hiểu trước đó:
multi-head attention,layer normalization,dropout,feed-forward layer&GeLU activations. Phần sau ta sẽ kết nối khối Transformer với các phần còn lại của kiến trúc GPT. -
-
Ý tưởng cốt lõi là cơ chế self-attention trong khối multi-head sẽ xác định và phân tích các mối quan hệ giữa từng token đầu vào. Ngược lại, mạng feed-forward sẽ sửa lỗi độc lập từng vị trí.
-
Code được triển khai tại phần
6. Transformer Blocktrong11. Placeholder-GPT.ipynb. -
LayerNorm được áp dụng trước MultiHeadAttention & mạng FeedForward, và Dropout được áp dụng sau để điều tiết mô hình và ngăn chặn overfitting. Cấu trúc này được gọi là
Pre-LayerNorm, các kiến trúc cũ hơn như Transformer nguyên bản áp dụng chuẩn hóa sau mạng self-attention & feed-forward, được gọi làPost-LayerNorm- thường dẫn đến động lực huấn luyện (training dynamics) kém hơn. -
Việc kích thước vector được giữ nguyên khi đi qua khối Transformer là thiết kế cho phép ứng dụng hiệu quả trên phạm vi rộng các tác vụ chuỗi sang chuỗi (Sequence-to-Sequence), nơi mỗi vector đầu ra tương ứng trực tiếp với vector đầu vào, duy trì quan hệ 1-1, đồng thời tích hợp thông tin ngữ cảnh từ khắp toàn bộ chuỗi input ban đầu.
Phần tiếp theo ta sẽ triển khai mô hình GPT hoàn chỉnh và quá trình chuyển đổi từ output vector sang văn bản text. 🌟🌟🌟