5. Pretraining on Unlabeled Data (Part 01)
Text Generation
-
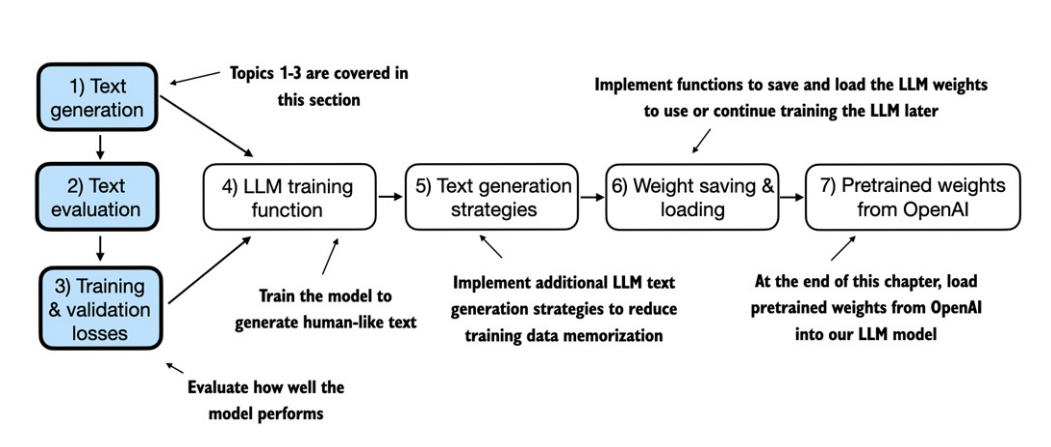
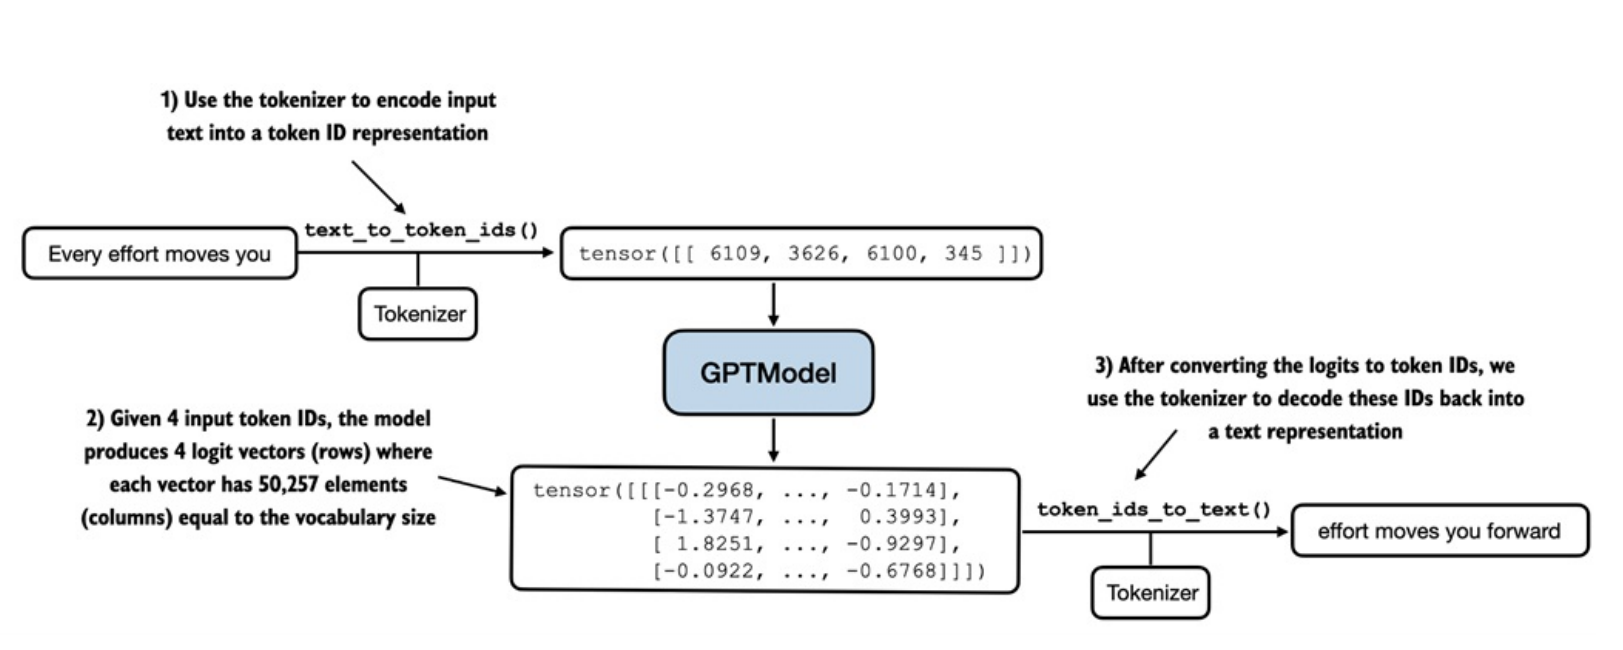
Quy trình sinh văn bản diễn ra qua các bước: Mã hóa (Encoding) Mô hình tính toán Embedding vector sang ID tokens ID tokens sang text.
-
-
Tuy nhiên mô hình hiện tại vẫn đang tạo ra văn bản ngẫu nhiên và khác biệt so với mục tiêu vì vẫn chưa được huấn luyện. Tiếp theo đây ta sẽ đến phần đánh giá hiệu suất của văn bản do mô hình tạo ra thông qua một đại lượng gọi là
"Hàm mất mát" (Loss). -
Hàm Loss không chỉ hỗ trợ việc đánh giá văn bản đầu ra, mà còn là nền tảng để triển khai việc huấn luyện sau này - công cụ để cập nhật trọng số mô hình để cải thiện đầu ra văn bản trong quá trình training.
Calculating Loss
-
-
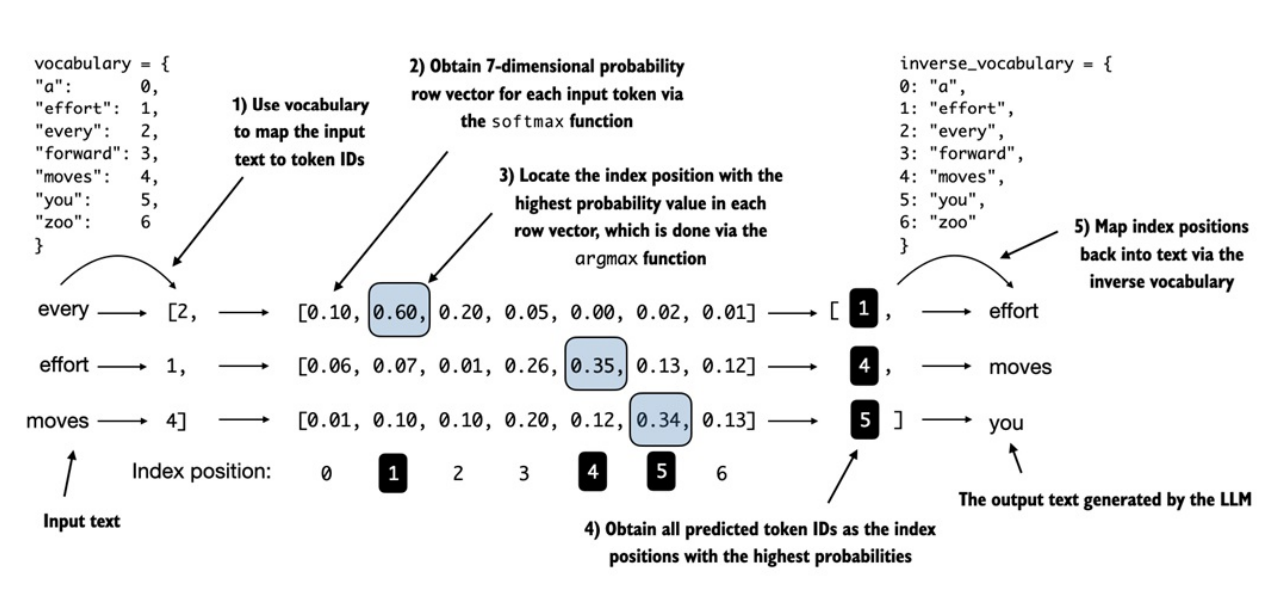
Hình trên mô tả tính toán Loss khi huấn luyện được triển khai như thế nào, với mục tiêu là đo lường "mức độ sai lệch" giữa các token được tạo ra so với token mục tiêu.
-
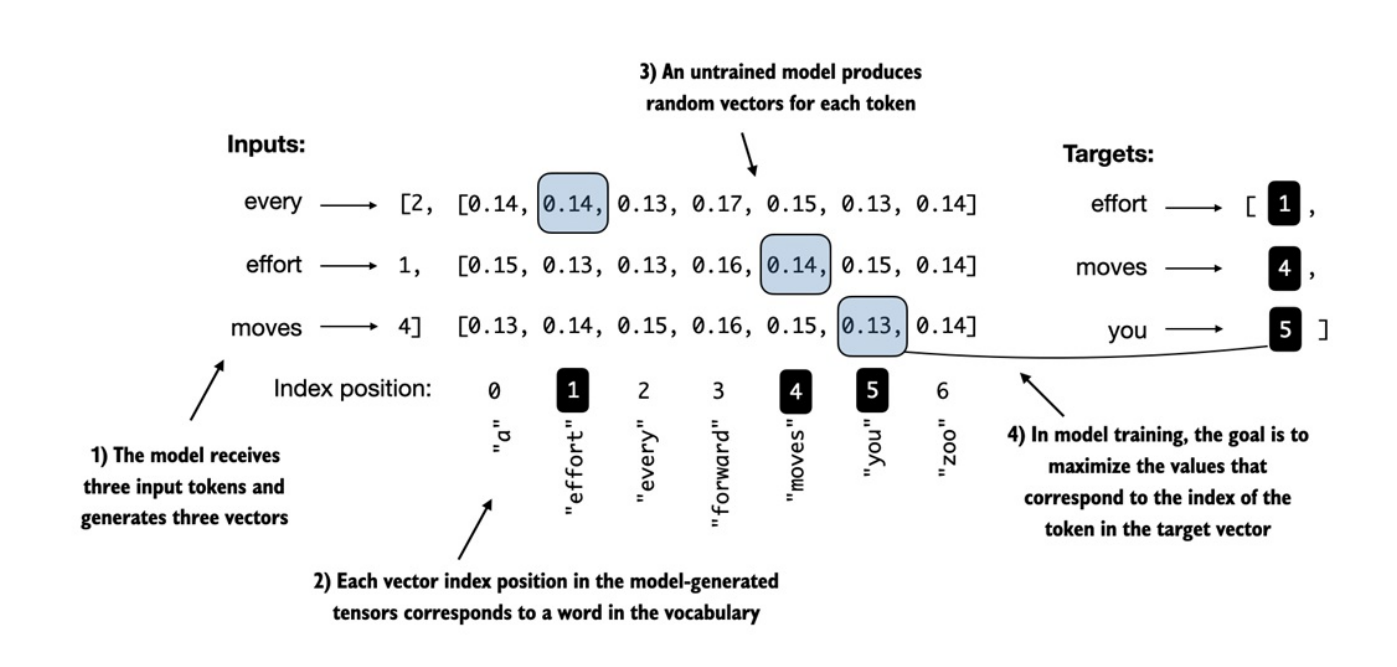
Mục tiêu của huấn luyện mô hình là làm tăng xác suất softmax tại các vị trí index tương ứng với các target token ID.
-
Trước khi huấn luyện, mô hình tạo ra các vectơ xác suất cho token tiếp theo một cách ngẫu nhiên. Mục tiêu của quá trình huấn luyện mô hình là đảm bảo các giá trị xác suất tương ứng với các target token ID được đánh dấu nổi bật tối đa, như hình dưới:
-
Lan truyền ngược (Backpropagation)
-
Làm thế nào để chúng ta tối đa hóa các giá trị xác suất softmax tương ứng với các target token. Về mặt tổng quan, ta cập nhật các trọng số mô hình (model weights) sao cho mô hình đưa ra các giá trị xác suất cao hơn cho các target token ID tương ứng mà ta muốn tạo ra. Việc cập nhật trọng số này được thực hiện thông qua một quá trình gọi là backpropagation (Xem thêm tại Appendix).
-
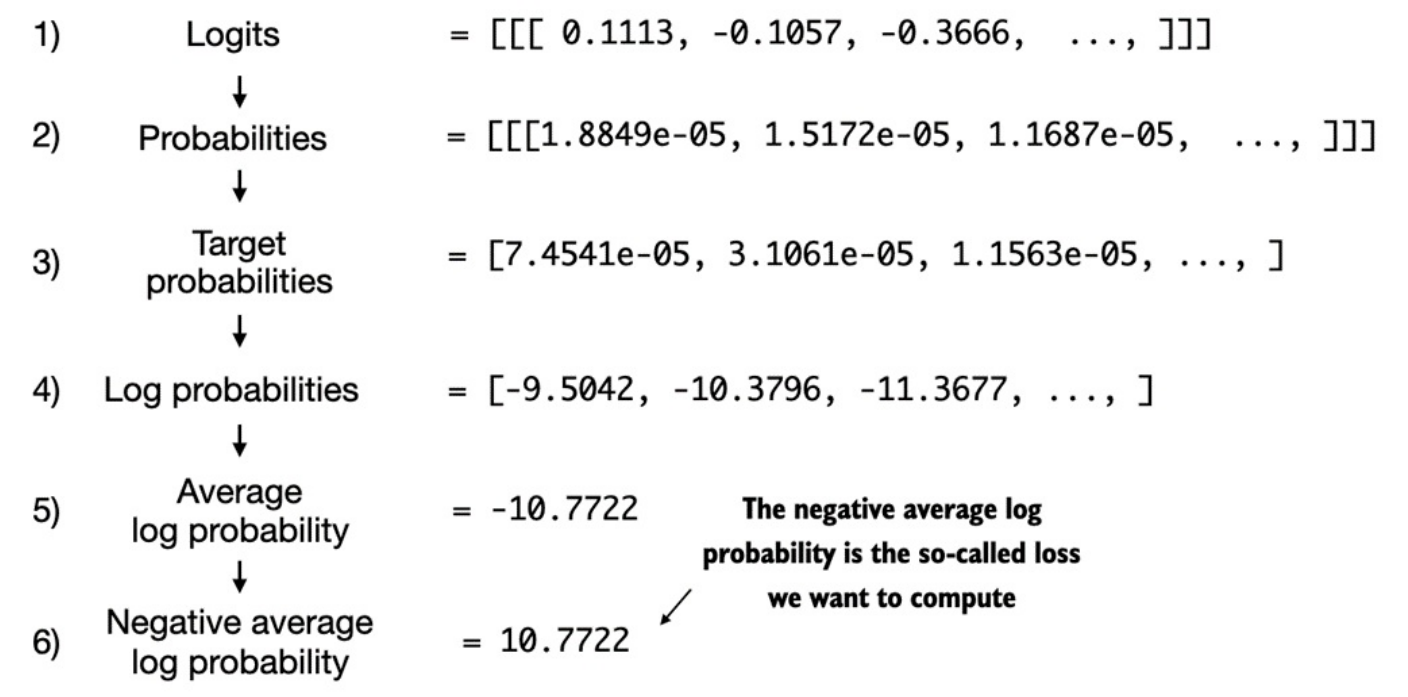
Lan truyền ngược đòi hỏi 1 hàm Loss dùng để tính toán chênh lệch giữa đầu ra dự đoán mô hình và đầu ra mong muốn thực tế. Các bước tính toán hàm Loss thể hiện qua hình dưới đây:
-
-
Logits là vector scores output của mô hình với độ dài bằng len(vocabulary), sau đó đưa qua hàm Softmax để có được Probabilities. Vì hiện tại chưa huấn luyện gì, nên probability của target token hiện tại sẽ rất thấp. Mục tiêu sẽ là tăng giá trị xác suất này lên tiến về 1.
-
Từ danh sách Probabilities ở trên, ta sẽ lấy ra các probability tương ứng với target token ID để tạo thành Target probabilities, sau đó tính toán Cross Entropy Loss trên vector target này (bước 4-6). Mục tiêu sẽ là kéo Negative average log probability này giảm xuống 0.
-
-
Hàm Loss Cross Entropy thường được dùng cho các bài toán phân phối xác suất này.
Độ phức tạp (Perplexity)
-
Thước đo này thường sử dụng cùng với Cross Entropy Loss để đánh giá hiệu năng mô hình, cung cấp cái nhìn trực quan hơn. Perplexity có thể được tính bằng công thức perplexity = torch.exp(loss), trả về kết quả ví dụ tensor(47678.8633).
-
Trong ví dụ này, giá trị trên tương đương với việc mô hình đang phân vân giữa khoảng 47.678 từ/token trong vocabulary để chọn ra token tiếp theo.