3. Coding Attention Mechanisms (Part 02)
-
"self" trong
self-attentionlà gì?-
Như ở phần trước, qua ảnh minh họa ta đã hình dung
attention truyền thốngdùng để kết nối encoder và decoder, giải quyết việc Decoder nên nhìn phần nào trong input. -
Với
self-attention, mỗitokentronginputkhông chỉ nhìnbản thân nómà còn nhìntoàn bộ các token khác trong chuỗiđể quyết định bản thân nên biểu diễn như nào. -
Ví dụ: “The cat sat on the mat”
-
Khi biểu diễn “cat”, mô hình có thể nhìn sang “sat” (động từ) để hiểu ngữ cảnh.
-
Khi biểu diễn “mat”, mô hình có thể nhìn cả “on” và “the” để rõ nghĩa.
-
-
3.3. Cơ chế self-attention đơn giản không có weights
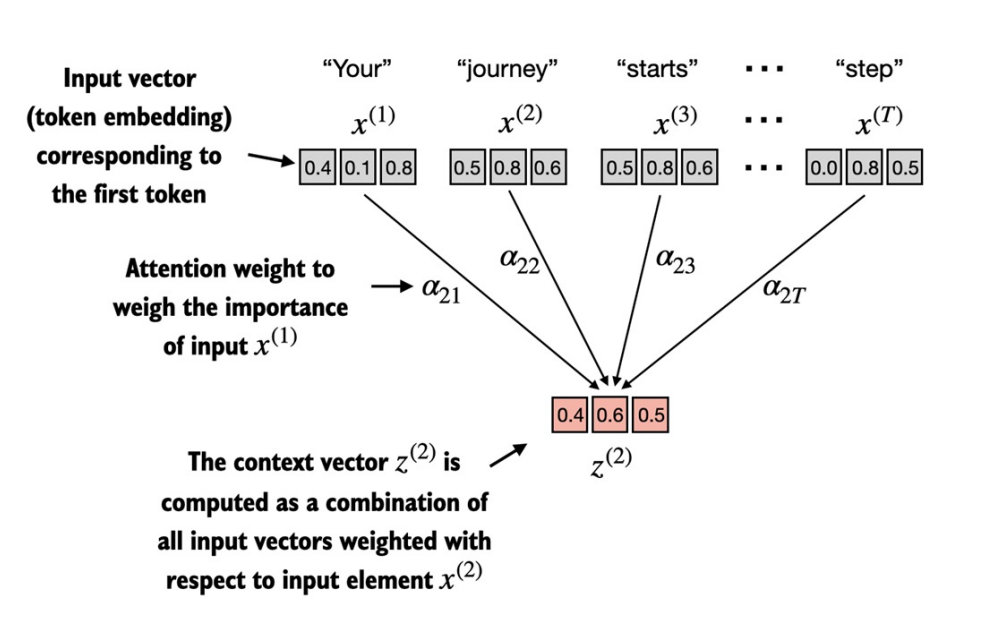
-
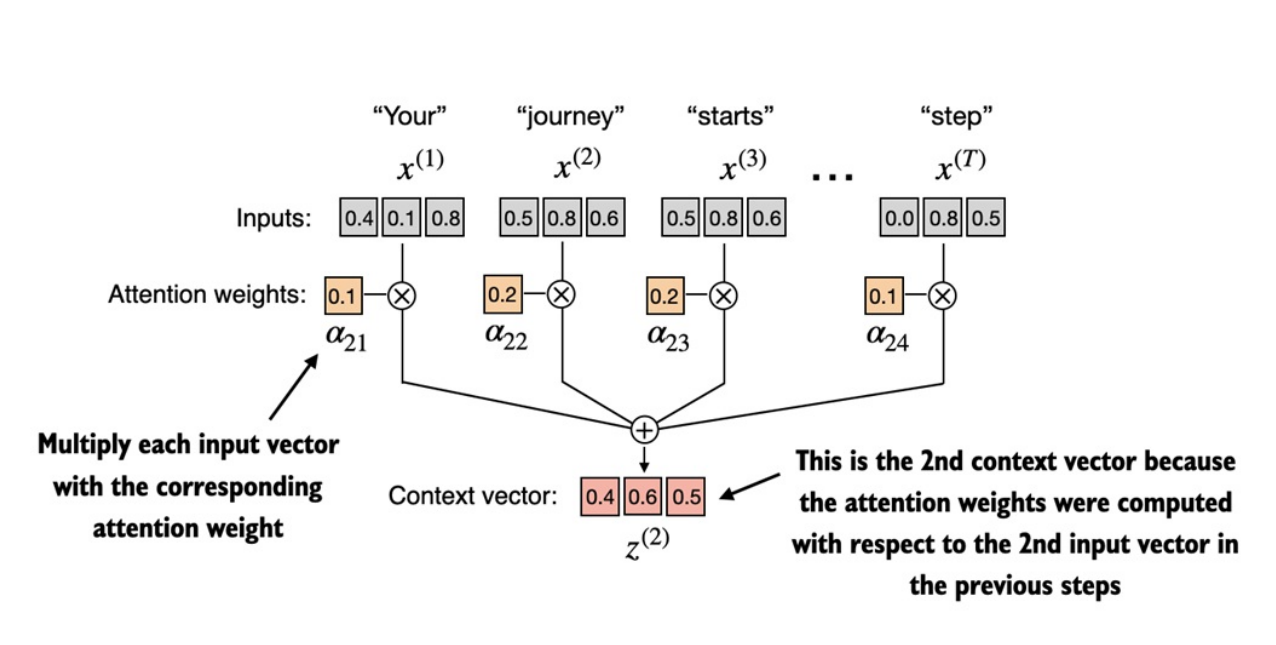
Chuỗi đầu vào :
-
Gồm phần tử: , , ..., .
-
Mỗi phần tử là
embedding vectorcủa từngtoken.
-
-
Attention weights :
- Mức độ quan trọng của từng token (bao gồm bản thân token 2 đó) đối với việc biểu diễn token số 2 trong ngữ cảnh toàn câu.
-
Mục tiêu của
self-attention:-
Với mỗi , ta tính ra 1
context vector. -
là
embedding vectorgiàu ngữ cảnh toàn câu.
-
-
Ví dụ cụ thể với từ
"journey"trong hình trên:-
là
embeddinggốc của"journey". -
Từ đó ta tính
embedding: vector"lấy"thông tin từ các token trong câu. Việc"lấy"nhiều hay ít phụ thuộc vào cácattention weights.
-
-
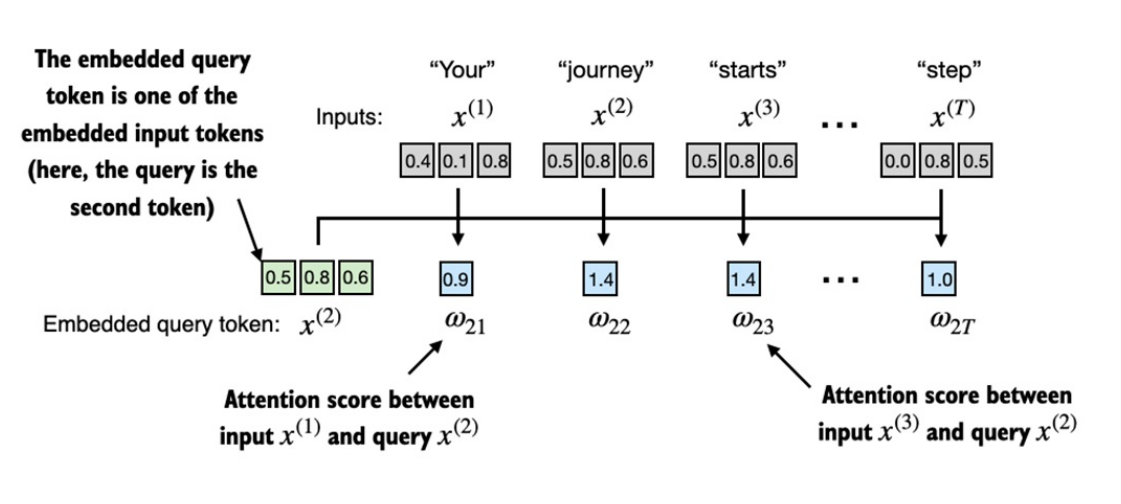
Bước đầu tiên để triển khai
self-attentionlà tính ra cácgiá trị trung gian. -
còn được gọi là
attention scoresthể hiện độ tương đồng giữa các token trong câu. -
Ta đang tính
context vectorcho token "journey", nên sẽ làmquery. -
Ta tính
dot product(tích vô hướng) với từngembeddingtrong chuỗi:-
-
Tích vô hướngcòn là thước đo độ tương đồng. Tích càng lớn hai vector càng cùng hướng, Tích càng nhỏ hoặc âm hai vector càng ngược hướng.
-
-
Kết quả ta có 1 dãy
attention scores.
-
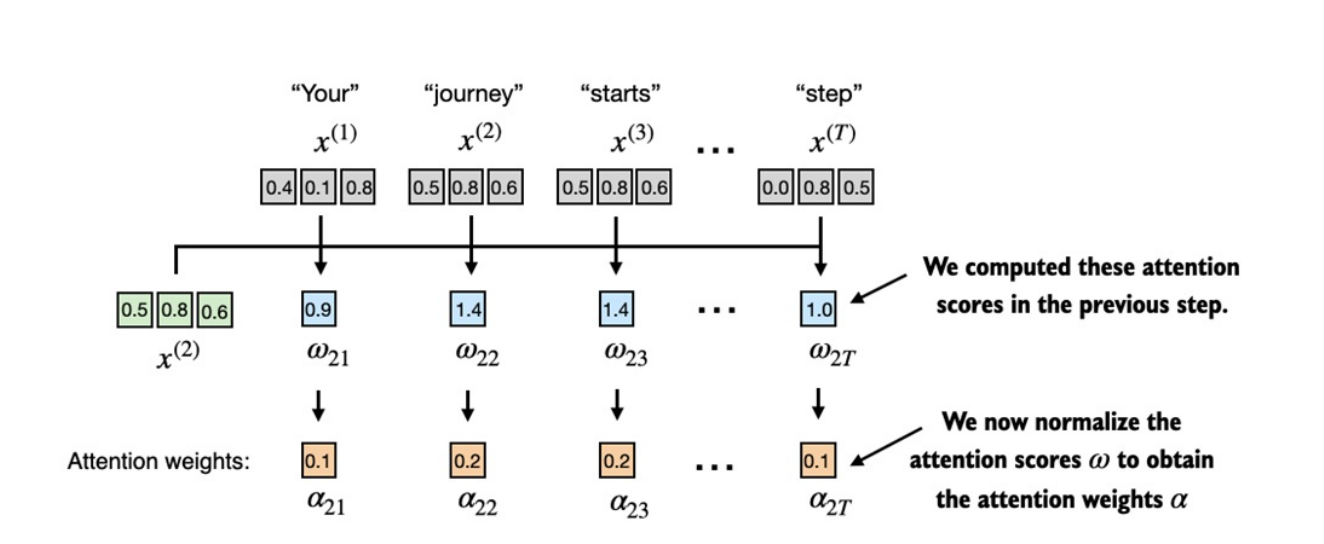
Danh sách
attention weightsđược tính bằng cách truyềnattention scoresqua hàmsoftmaxđể chuyển về phân phối xác suất. -
Code minh họa xem tại
6. Self-attention_without_weights.ipynb.
-
Sau khi đã có
attention weights,context vectorđược tính bằng công thức sau: -
Phần sau ta sẽ tiến hành tính toán tất cả các
context vectornày đồng thời, thay vì chỉ tính cho mộttoken 2như này.
Tính toán attention weights cho tất cả các token đầu vào
-
Ở phần trước ta đã tính
attention weights&context vectorchoinput token thứ 2. Ở phần này ta sẽ mở rộng phép tính này để tínhattention weights&context vectorcho tất cả cácinput token. -
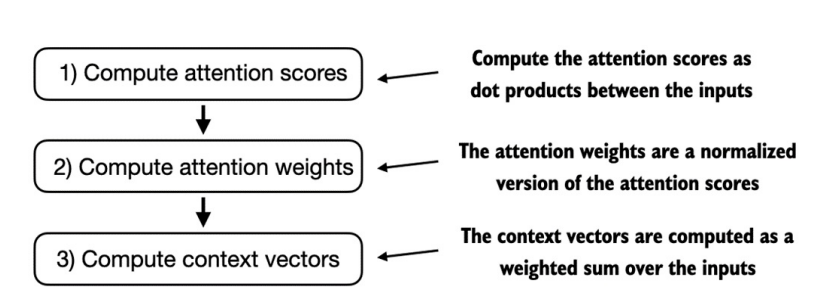
Quá trình này nhìn chung được tính toán qua 3 bước:
-
Đầu tiên, ở bước 1, ta sử dụng
2 vòng forđể tínhdot productcho tất cảcác cặp input tokens. Tuy nhiên vòng lặp thường chạy chậm, thay vào đó ta có thể dùng phép nhân ma trận (matrix multiplication) () -
Cả 3 bước này được triển khai tại
6. Self-attention_without_weights.ipynb.