3. Coding Attention Mechanisms (Part 01)
-
Cơ chế
attentionlà 1 chủ đề rất rộng. Trong phần này, chúng ta sẽ triển khai4 biến thểkhác nhau của attention mechanisms như hình dưới đây: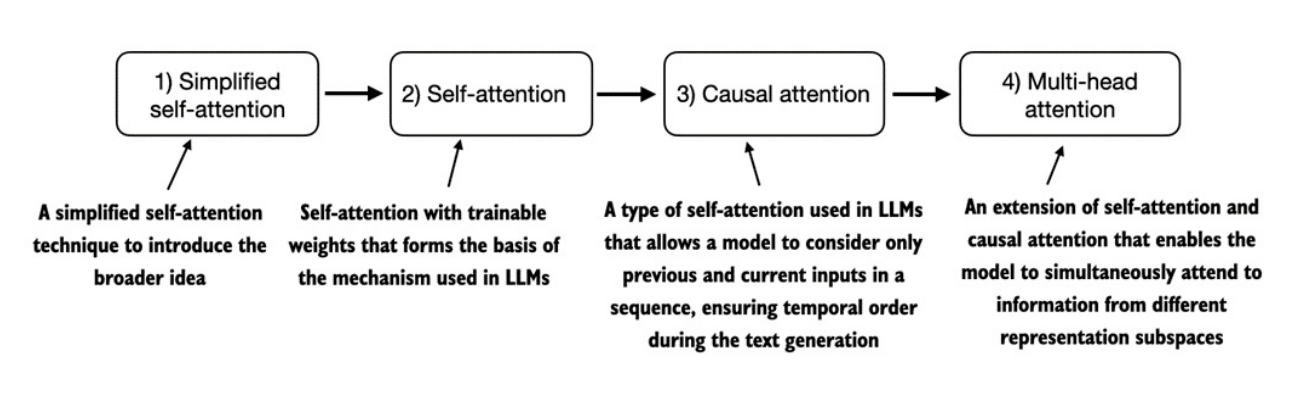
-
Bắt đầu với phiên bản đơn giản của self-attention (1) trước khi bổ sung các weights có thể train (2).
-
Tiếp theo, cơ chế casual attention (3) thêm
1 maskvào self-attention, cho phép LLM sinh từng từ một. -
Cuối cùng, multi-head attention tổ chức attention mechanisms thành nhiều "head" song song, nắm bắt nhiều đặc trưng của input data.
-
3.1. Khó khăn trong việc mô hình hóa chuỗi dài
-
Trước khi đi vào cơ chế
self-attention, vốn là core của LLM, hãy xem vấn đề của các kiến trúc không có attention xuất hiện trước LLM là gì.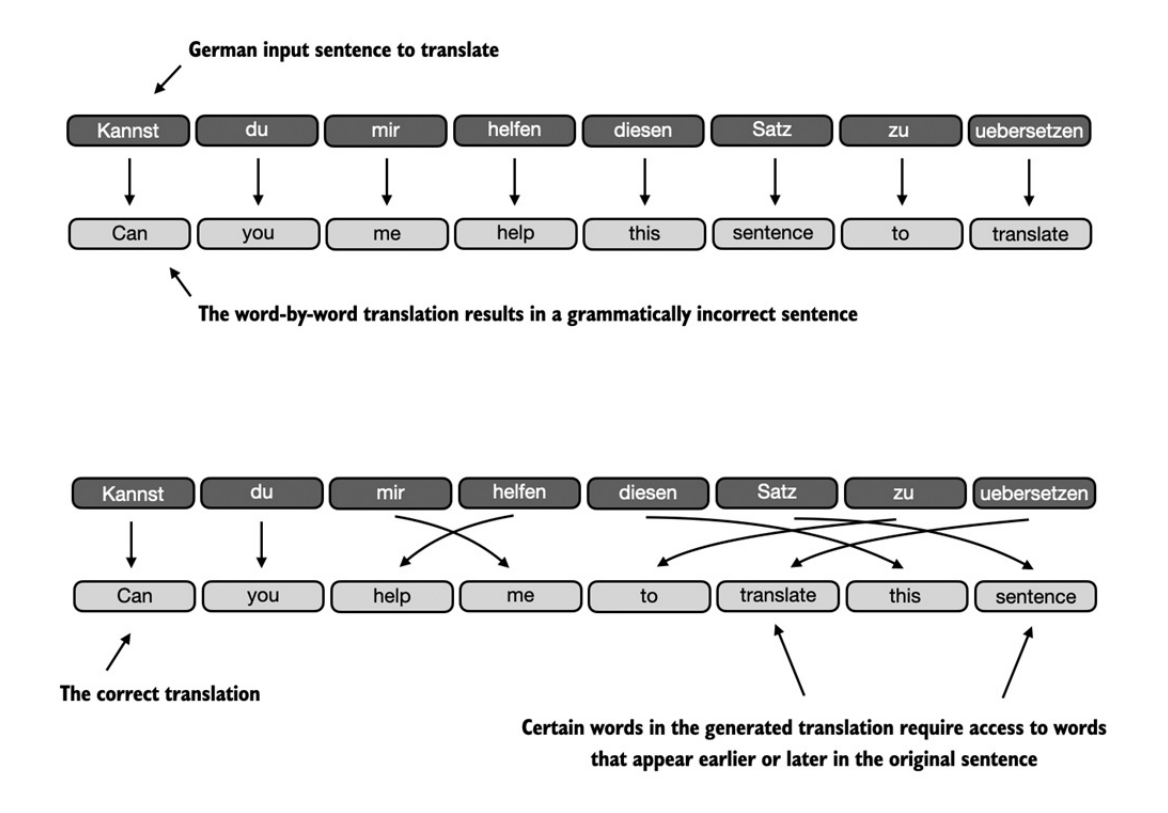
-
Giả sử chúng ta muốn phát triển một
mô hình dịch ngôn ngữ. Ý tưởng ban đầu sẽ là dịch từng từ một, nhưng như hình trên, ta không thể chỉ đơn giản dịch từng từ một từ German qua English do khác biệt vềcấu trúc ngữ pháp. -
Để giải quyết vấn đề này, người ta thường sử dụng một
mạng neuralvới 2 module conEncoder và Decoder. Nhiệm vụ của Encoder là đọc và xử lý toàn bộ văn bản, sau đó Decoder sẽ sinh ra văn bản dịch. -
Trước khi
Transformerra đời, Mạng nơ-ron hồi quy (Recurrent Neural Networks - RNNs) là kiến trúcencoder-decoderphổ biến nhất cho dịch máy. -
Trong 1
RNN cơ bản(1 layer RNN) có công thức sau:-
hidden state, với:-
là
hidden statecủa bước trước; -
là
inputtại thời điểmt; -
là
hidden statetại thời điểmt;
-
-
output, với:- :
hidden statetại thời điểmt; - :
hàm kích hoạt(ví dụ softmax nếu là phân phối xác suất từ tiếp theo)
- :
-
-
Từ công thức trên có thể thấy rằng,
đầu ra của bước trước được đưa trở lại làm đầu vào của bước tiếp theo. -
Trong một
encoder-decoder RNN, văn bản đầu vào được đưa vàoencoder, nó sẽ xử lý lần lượt theo từng token. Ở mỗi token, encoder sẽ cập nhật trạng thái ẩn (hidden state) của mình, cố gắng nén toàn bộ input data vàofinal hidden state. Sau đó,decodersẽ dùngfinal hidden statenày để sinh racâu dịch, từng từ một. -
Hidden state thứ
tsẽ được tạo ra bằng hidden state thứt-1và token thứt-1(công thức thứ 1, với là ở decoder). Token thứt() sẽ được tạo ra bằng cách sử dụng hidden state thứt(công thức thứ 2)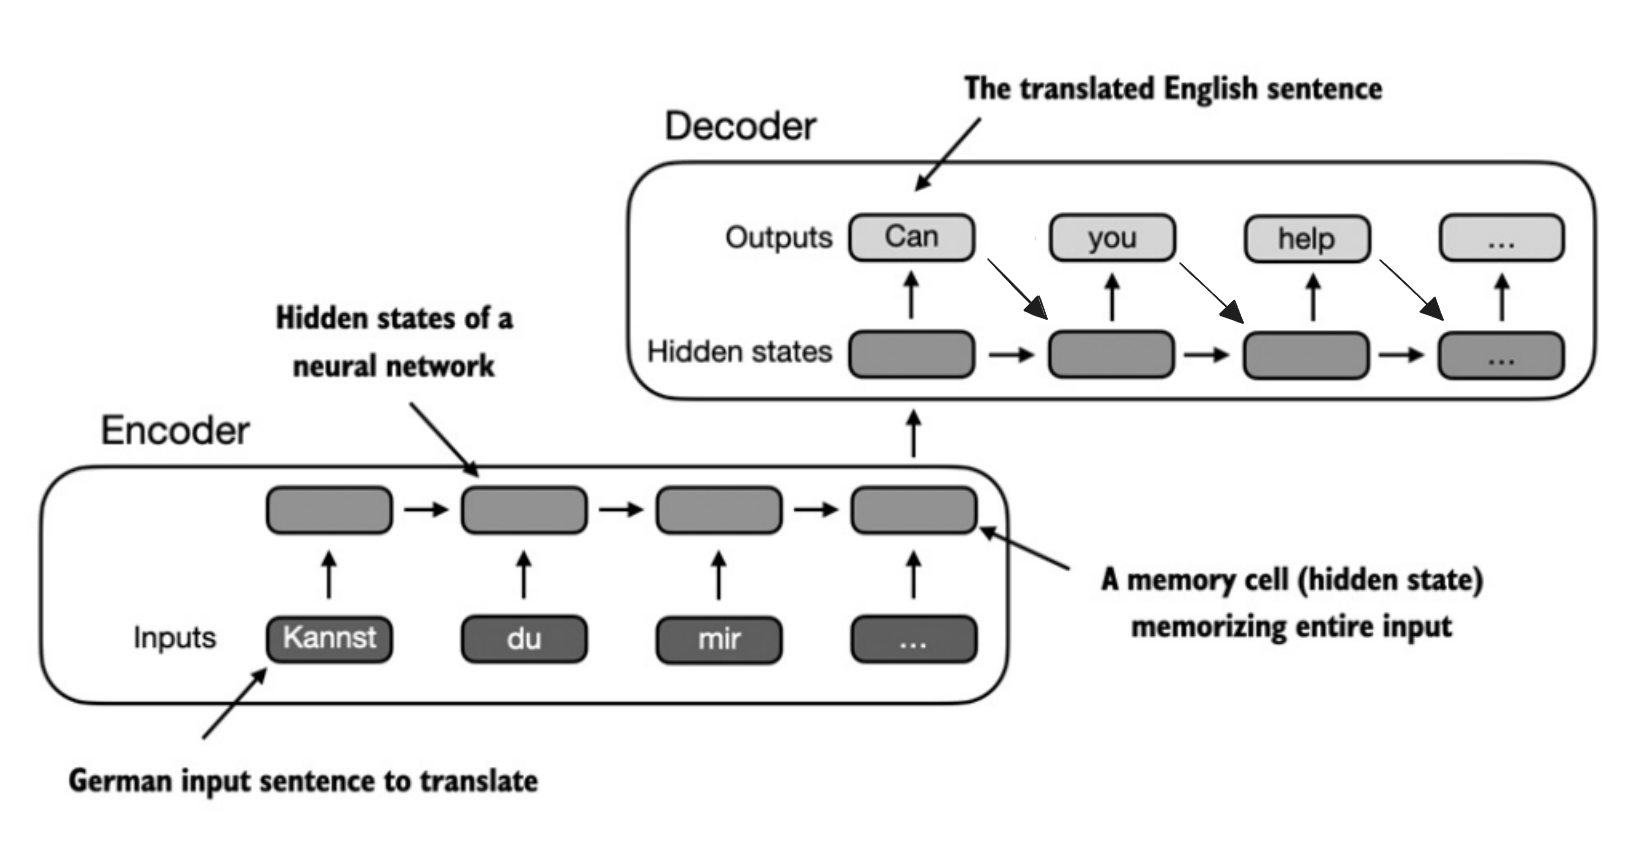
-
Vấn đề của
encoder-decoder RNNlà trong lúcdecoding, RNN không thể truy cập vào các hidden state phía trước mà chỉ dựa được vàofinal hidden state(có thể thấy rõ từ công thức). Do đó, toàn bộ input data chỉ được nén vào 1 vector duy nhất. Điều này dễ làmmất mát thông tin, đặc biệt với câu dài, có phức tạp quan hệ xa.
3.2. Nắm bắt các quan hệ phụ thuộc với cơ chế attention
-
Sau 3 năm,
Transformergốc ra đời với cơ chếself-attentionlấy cảm hứng từ với cơ chế attention -
RNNcó nhược điểm là buộc phải ghi nhớ toàn bộ câu đã mã hóa chỉ trong 1 hidden state duy nhất. -
Để khắc phục, năm 2014 cơ chế
Bahdanau attentionra đời:-
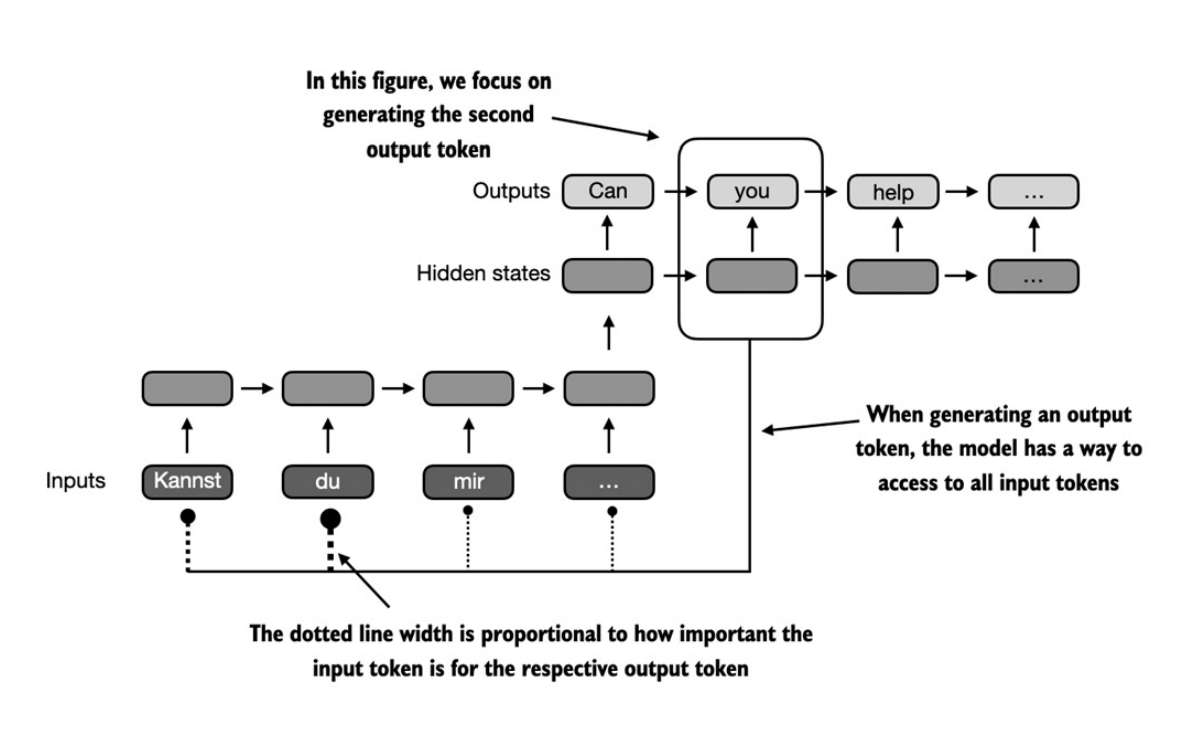
Cơ chế này chỉnh sửa
encoder-decoder RNNđể decoder có thể lựa chọn các hidden state khác nhau của chuỗi input tại mỗi bước decode. -
Hình dưới đây minh họa ý tưởng tổng quát của
attentionchứ không mô tả chính xác cách triển khai Bahdanau. -
-
-
Sau 3 năm,
Transformergốc ra đời với cơ chếself-attentionlấy cảm hứng từBahdanau attention. -
Tiếp theo chúng ta sẽ đi sâu vào code cơ chế
self-attentiontrước khi code các phần khác của LLM giống GPT.